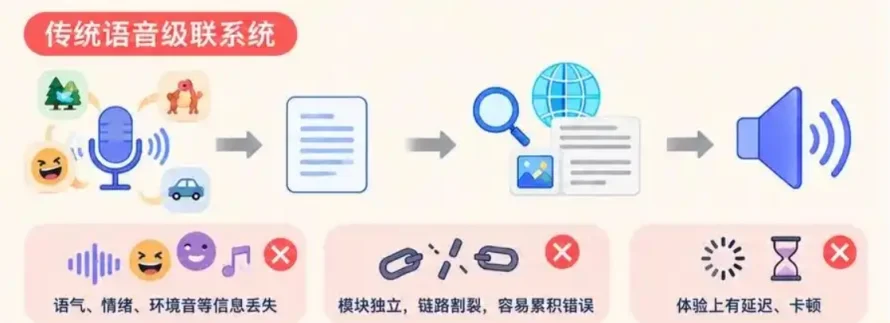
按照以往的经验,大模型音频处理普遍采用语音转文字的级联方案,存在显著技术缺陷。该模式会丢失语音自带的情绪、语气、环境音等关键信息,导致模型场景判断不全面。同时,这种架构将语音转写、声纹识别等功能拆分为多个独立模块串联运行,链路存在断点,不仅...